06 Nov 2026
En les dues entrades anteriors hem parlat del punt de partida del projecte i de com vam construir el domini i l’equip. En aquesta toca una decisió molt menys lluïda: com connectem Shopify amb un OMS que encara estàvem desacoblant, amb una data de lliurament que no depenia de nosaltres.
L’objectiu del projecte no era tenir una arquitectura millor, sinó arribar a dues dates: la campanya d’estiu i el Black Friday. Entre l’una i l’altra hi ha l’agost, amb vacances pel mig i menys mans disponibles de les que sembla en un diagrama de Gantt. Això volia dir que qualsevol decisió tècnica que ens fes perdre setmanes s’havia de justificar molt bé, i que l’MVP havia d’estar en producció al juliol de 2023.
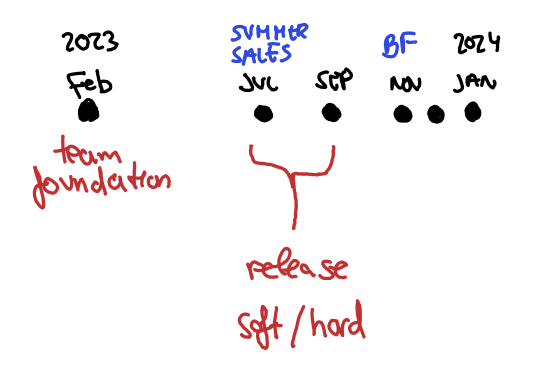
L’arribada de Shopify la vam plantejar en dues fases: primer els mercats amb menys volum (soft launch) durant l’estiu, i després els més grans (hard launch) abans del Black Friday. El raonament és senzill: un error en un mercat petit es nota menys i es pot corregir abans que el mateix error arribi al mercat que factura. No és només una precaució de cara al client; és la manera de descobrir problemes amb un cost que encara és assumible.
Per què vam fer l’aplicació nosaltres
Shopify recomana treballar amb un partner, és a dir, amb un desenvolupador o una agència especialitzada en el seu ecosistema, perquè el client tingui suport tècnic adequat. Té sentit: la plataforma està pensada perquè el comerciant no s’hagi de preocupar de res més que del negoci.
En el nostre cas vam decidir fer la integració nosaltres mateixos. La conseqüència pràctica és que, per crear una custom app, vam haver de passar pel mateix camí que un partner: entendre quins tipus d’aplicació ofereix Shopify, quins permisos (scopes) necessita cada operació i de quins esdeveniments havíem de rebre informació. L’API està ben documentada, però documentació bona no és el mateix que familiaritat amb un ecosistema. Aquell temps de corba d’aprenentatge no apareix a cap estimació i, amb el calendari que teníem, es pagava en un altre lloc.
Tres maneres de rebre els canvis
Vam posar sobre la taula tres opcions: webhooks, Google PubSub i Amazon EventBridge. Cap de les tres ens estalviava la feina de traduir el model de Shopify al nostre; el que canviava era com arribaven els esdeveniments i, sobretot, qui responia quan alguna cosa fallava.
| Opció |
Què aporta |
Què implica per a nosaltres |
Per què la vam valorar així |
| Webhooks |
Notificació HTTP directa a un endpoint nostre |
Gestionem nosaltres el receptor, els reintents, la idempotència i els límits |
Capaç de posar-se en marxa de seguida; encaixava amb el calendari |
| Google PubSub |
Missatgeria gestionada amb lliurament asíncron i reintents |
Cal integrar un servei extern i entendre’n el model de subscripcions |
Hagués absorbit pics de volum, però no el coneixíem prou |
| Amazon EventBridge |
Bus d’esdeveniments amb regles i filtratge |
Depèn de l’ecosistema AWS i de qui publica els events |
Mateix problema: menys experiència i més superfície |
Amb les setmanes que teníem i un coneixement limitat dels sistemes de missatgeria gestionada, vam triar webhooks. Ho dic en el sentit literal del terme pragmàtic: la decisió que es pot defensar amb el context d’aquell moment, no necessàriament la que hauria sortit d’un exercici de disseny sense dates.

Què és un webhook i per què no pots respondre tard
Un webhook és una crida HTTP que fa Shopify contra una URL nostra quan passa alguna cosa: es crea una comanda, es paga, s’actualitza un enviament. El cos de la petició porta l’esdeveniment; en les capçaleres hi va una signatura que permet verificar que ve realment de Shopify i no de qualsevol que hagi descobert la nostra URL.
El detall que condiciona tota la resta és el temps. Shopify espera un 200 en cinc segons; si no el rep, considera l’entrega fallida i la reintenta. D’aquí surten dues obligacions que no són evidents quan llegeixes la documentació per primer cop:
- La resposta s’ha de poder enviar sense haver acabat el treball. Si traduïm i desem la comanda abans de respondre, el temps de la nostra base de dades passa a formar part del temps d’entrega.
- L’operació ha de ser idempotent. Un reintent és un duplicat, i el sistema ha de saber que aquell event ja l’ha processat.
Per això vam ficar Symfony Messenger entremig. El controlador només verificava la signatura, creava el missatge i el deixava a la cua; el consumidor feia la traducció i l’escriptura. El 200 es podia enviar sense esperar que acabés el treball real.
Això no elimina el problema, el trasllada. Si la cua s’atura, les comandes deixen d’integrar-se igualment; l’avantatge és que la fallada és visible i reintentable, en lloc de silenciosa des del punt de vista de Shopify. També obliga a decidir el transport i a tenir el consum supervisat, que és feina que amb una crida directa no hauries de fer.
Del payload al domini: la capa ACL
El cos d’un webhook no és el nostre domini. Arriba amb la forma que decideix Shopify, amb els seus noms de camps, els seus estats i les seves convencions. Si deixem que aquesta forma entri al codi, Shopify passa a dictar com és el nostre model, i el desacoblament que havíem començat a la part anterior es desfà per la porta del darrere.
Per això vam construir una Anti-Corruption Layer que transforma el payload en objectes del domini abans que res més els toqui. La capa fa tres coses: valida el que arriba, tradueix els camps externs als nostres value objects i concentra en un sol lloc les decisions per als casos on els dos models no encaixen. Quan Shopify canvia un camp, es canvia aquí i no a vint llocs.
L’agregat Order del nostre domini no és una estructura plana. Està compost per diverses entitats: Payment, DeliveryOption, Customer, BillingAddress i DestinationAddress. El payload que arriba de Shopify no té aquesta forma, i la feina de l’ACL és precisament convertir-ne un en l’altre.
flowchart TD
    Order["Order<br/>aggregate root"]
    Order --> Payment["Payment"]
    Order --> DeliveryOption["DeliveryOption"]
    Order --> Customer["Customer"]
    Order --> BillingAddress["BillingAddress"]
    Order --> DestinationAddress["DestinationAddress"]
Per muntar-lo vam fer servir el patró Builder. Un constructor amb cinc paràmetres compostos és difícil de llegir i de mantenir, i no deixa lloc per validar cada part abans que formi part de l’agregat. Amb el Builder, cada entitat es construeix a partir del payload i l’Order només existeix quan totes les peces hi són. Així la traducció queda concentrada en un sol lloc i no escampada pel codi que consumeix l’agregat.
La fricció que no és de codi
La part tècnica es va poder resoldre. La que va costar més va ser acceptar que Shopify té un model més estricte que el nostre i que això no és un defecte del proveïdor: és una conseqüència de vendre a molts comerços amb les mateixes regles.
El lloc on això es va notar primer no va ser el codi, sinó el vocabulari. Nosaltres teníem unificats els estats d’una comanda en un procés lineal: comanda pagada, en preparació, enviada, i uns quants més. Un sol camp, un sol enumerat, i el codi que el consultava només havia de comparar-lo amb una posició dins de la seqüència. Quan algú preguntava per una comanda, la resposta era en quin punt del procés estava.
Shopify no ho modela així. Separa quatre dimensions que nosaltres havíem barrejat en una sola:
| Eix |
Què descriu |
| Estat de la comanda |
Si la comanda està oberta, arxivada o cancel·lada |
| Estat del pagament |
Si el cobrament està pendent, autoritzat, pagat, retornat o anul·lat |
| Estat de preparació (fulfillment) |
Si el contingut s’ha preparat del tot, en part o gens |
| Estat de devolució |
Si hi ha devolucions obertes sobre les línies de la comanda |
Els noms concrets dels valors depenen de la versió de l’API i del recurs, però la separació en quatre eixos es manté. La diferència amb el nostre model no és de nomenclatura: aquests quatre eixos es mouen de manera independent, i un sol enumerat no pot expressar el cas en què no coincideixen.
Pensa en una comanda amb tres línies. Una surt en un enviament, una altra queda pendent per falta d’estoc i el client demana tornar un tercer article que ja ha rebut. Pagament complet, preparació parcial i devolució oberta conviuen alhora. En el model lineal cal triar una sola paraula, i qualsevol paraula que triïs menteix sobre els altres eixos.
El model lineal no era un error de disseny. Funciona mentre la comanda avança en bloc: tot es paga alhora, tot es prepara alhora i tot s’envia alhora. Quan el negoci comença a vendre per canals on l’enviament parcial i la devolució per línia són normals, aquest supòsit deixa de valer, i el camp únic passa de simplificar a amagar informació.
Això té una conseqüència incòmoda: cada combinació dels quatre eixos ens obliga a decidir què vol dir amb el nostre estat únic, i en molts casos la decisió és una pèrdua. Un retorn parcial i una comanda enviada acaben col·lapsats en el mateix valor, i el que guanyem en simplicitat ho paguem en informació.
La sortida no va ser traduir millor els quatre eixos cap al nostre enumerat. Va ser qüestionar el concepte mateix. Com que ens estàvem desacoblant principalment de l’e-commerce, podíem canviar el nostre Order Management System sense comprometre el canal de venda principal. Així que, internament, les nostres Order —l’agregat que havíem muntat amb el Builder— van passar a ser FulfillmentOrder. És el que gestiona el nostre OMS: les comandes que tractem són fulfillment orders, la feina de preparar-les, no la comanda de venda del client.
Aquest canvi de concepte és el que ens va alliberar de la majoria d’estats. Del model de Shopify només ens interessava una pregunta: si aquella comanda s’havia de preparar o no. La resta —si el pagament estava autoritzat o capturat, si el client havia obert una devolució— no era responsabilitat nostra en aquell moment, i per tant no havíem de representar-ho.
La feina es va traslladar al negoci, que és on havia d’estar. Ens calia tenir clar en quins punts una comanda podia preparar-se, perquè fins que no rebíem l’ordre la comanda es quedava en un estat pendent, i era aquella ordre la que la passava a “En preparació”. El que abans era una posició dins d’una seqüència va passar a ser una decisió amb regles explícites.
Aquí és on la fricció deixa de ser tècnica. El codi de traducció és mecànic un cop saps què vols dir; el que costa és acordar què vol dir cada paraula amb el negoci, perquè és el mateix vocabulari que fan servir per parlar amb el client. Acceptar que una part del nostre model era més pobra del que pensàvem no es va resoldre amb una capa de traducció: es va resoldre decidint que no havíem de representar allò que no ens tocava.
Juliol: el pla de sortida
Amb la data límit de la campanya d’estiu al juliol de 2023, vam prioritzar tres coses:
- Proves de rendiment. Tests d’estrès per comprovar que el sistema aguantava el que li havíem de demanar.
- Soft launch. Migració progressiva de mercats a Shopify a partir del 17 de juliol, per poder revertir sense que afectés tothom alhora.
- Monitoratge i ajustos. Identificació de problemes i recollida de feedback durant l’agost, amb marge per corregir abans del hard launch.
El pla era raonable i el vam complir. El que no teníem al diagrama era una altra cosa: els sistemes nostres que encara apuntaven al domini antic.
Setembre: el que els tests no havien vist
Durant el hard launch, al setembre, van ser uns dies caòtics. Les comandes seguien entrant pels webhooks; l’OMS les rebia i les processava. El que va fallar va ser la comunicació de l’OMS cap a Shopify: al nostre sistema tot era correcte, però les actualitzacions es quedaven a la cua fins que vam poder tornar a enviar-les. A l’e-commerce, les comandes no s’actualitzaven: ni l’estat, ni la informació d’enviament, ni el número de seguiment, ni el transportista. Això afectava el client i el nostre equip d’atenció al client.
La causa era una aplicació legacy que feia peticions al nostre e-commerce de manera recorrent: un script amb threads que actualitzava informació de comandes. Quan vam passar el domini principal a Shopify, aquell script va continuar fent la mateixa feina, però les seves peticions anaven a adreces de Shopify que no existien. Cada crida era un 404, i Shopify va bloquejar la nostra IP.
El segon problema va ser l’abast. Aquella IP no era només de la integració: hi havia diversos sistemes que hi sortien, el mateix OMS i una altra aplicació de loyalty. Quan Shopify va bloquejar l’adreça, no va bloquejar el script; va bloquejar tot el que sortia cap a Shopify. Per això l’OMS podia continuar treballant i no podia notificar res a l’e-commerce.
Els tests d’estrès mesuren la nostra infraestructura amb càrrega sintètica. No mesuren que hi hagi un client nostre, oblidat, apuntant a una URL que hem deixat de servir, ni que la nostra adreça de sortida sigui compartida amb sistemes que no formen part de la integració. En tots dos casos la fallada no ve del que el proveïdor ens envia, sinó del que el proveïdor rep de nosaltres.
Diagnosticar des de fora
L’error era nostre, i això no ho discuteixo. El que va fer el problema molt més car del que calia va ser el temps que vam trigar a saber què passava, i en això no hi vam tenir tota la culpa.
Quan tens la IP bloquejada, el que necessites no és un article de documentació: necessites que algú de dins et digui per què. El camí habitual és obrir un cas al suport i esperar. En el nostre cas això es va convertir en un periple. Diversos contactes amb agents diferents, cadascun començant de zero, i el nostre key account sense donar-hi resposta. La sensació va ser d’ignorància i de desatenció més que de dificultat tècnica.
El punt d’inflexió va ser trobar un agent que s’ho va prendre mig seriosament i ens va donar pistes sobre on podien ser els problemes. Amb aquelles idees vam poder mirar en la direcció correcta. No sé si hauria estat així amb un altre proveïdor, i no ho puc afirmar; el que sí que puc dir és que la diferència entre un agent i un altre va decidir quant de temps vam estar bloquejats.
Del cost d’això se’n parla poc quan es compara un servei amb un altre. Quan tries com integrar-te amb una plataforma, la documentació és la part visible. L’altra part és què passa quan la documentació no respon la teva pregunta, i això només ho descobreixes quan ja hi ets a dins.
Els webhooks no eren el problema
Amb la IP bloquejada, vam tornar a les tres opcions del principi. El webhook és un HTTP contra una URL nostra: Shopify espera un 200 en cinc segons i, si no el té, reintenta. EventBridge i Pub/Sub deixen els events en un bus; Shopify ja no espera el 200 a casa nostra. Sembla que, si haguéssim triat el bus, setembre hauria anat d’una altra manera.
Les comandes, però, seguien entrant. Shopify continuava cridant el nostre endpoint, el controlador continuava responent 200 i Messenger continuava deixant el missatge a la cua. L’OMS tenia les comandes i les podia preparar. El que havíem assumit en triar HTTP —el temps, els duplicats, que dues notificacions de la mateixa comanda poden arribar intercanviades— no es va trencar aquella setmana.
Es va trencar l’altra direcció. L’OMS volia actualitzar Shopify, i aquelles peticions sortien per la mateixa IP que el script que rebia 404. Shopify va bloquejar l’adreça i tot el que anava cap a ells va parar. Un bus no hauria canviat el camí de sortida. EventBridge i Pub/Sub diuen on Shopify envia els events; no diuen per on sortim nosaltres cap a l’Admin API, ni quin script antic continua cridant una URL que ja no existeix, ni quant triga el suport a explicar-nos el bloqueig.
Si més endavant canviem com arriben els events, haurà de ser per un problema d’entrada. Aquest no ho era.
Balanç
La integració va complir l’objectiu: al juliol l’MVP era en producció i els mercats petits van començar a operar amb Shopify. També va deixar una base aprofitable, perquè la traducció del model i l’ACL són independents del transport que hi hagi a sota.
El preu va ser carregar sobre la nostra aplicació la responsabilitat de la fiabilitat d’una integració que no controlem. Això s’aguanta si el volum és el que havies previst i si tot el que et rodeja està al dia. Al setembre vam comprovar que cap de les dues coses es pot donar per feta: les comandes seguien entrant, però no podíem dir-li res a Shopify. La que ens va deixar així no va ser la càrrega del proveïdor, sinó un script nostre que encara cridava al domini d’abans.
I una cosa que no surt als diagrames: mentre la cua s’omplia, el temps de reparació no el va marcar la nostra capacitat tècnica, sinó la velocitat amb què vam aconseguir que algú del proveïdor ens fes cas.
19 Jan 2025
Al començar un projecte complex com el que estem abordant, és essencial tenir el màxim context possible, però tambe partir de zero en el coneixement del domini i anar explorant amb l’ajuda dels domain experts. Aquesta activitat no només ajuda a l’equip tècnic a alinear-se amb els objectius del negoci, sinó que també ajudar a fer-se un mapa global establint les bases per prendre millors decisions al llarg del cicle de vida del producte.
Per entendre com funcionava l’aplicatiu existent, identificar els diferents procesos que s’executaven i saber com estaven representats al codi així com establir un llenguatge comú amb l’anterior equip i els usuaris actuals del aplicatiu vam realitzar unes primeres sessions que no van ser gaire fructíferes, fins al punt de valorar si podiem ferun traspàs més traumàtic prescindint d’aquestes i espavilar-nos pel nostre compte.
EventStorming
Al incorporar-me com a tech lead des d’un principi vaig tenir clar que degut a la complexitat del projecte i si volia que l’equip tingués un ownership real del producte haviem de donar un enfocament domain-driven tant al projecte com a l’equip.
Això ens permetria moure el domini al centre de la narrativa, d’aquesta manera alineariem tot l’equip al voltant d’un llenguatge comú (ubiquitous language) que ens facilitaria la comunicació i ens permetria fer un mapa de l’estat actual de l’aplicació.
Així que un cop format aquest equip inicial vam començar a prepar sessions d’EventStorming. Aquesta metodologia visual ens va ajudar a descompondre els processos clau del sistema i identificar esdeveniments i entitats de domini rellevants.
Per a facilitar les sessions vam utilitzar una plantilla de Miro que ja porta una mica de guía i llegenda de les referències claus que s’han de tenir en compte per enfocar una sessió d’aquest tipus. Si voleu fer una sessió vindria bé que els participans tinguin un mínim de noció d’alguns conceptes amb els que hauran de trrballar, ja sigui fent fer una mica de prework o fer una explicació al iniciar la sessió.
flowchart TD
    subgraph Legend["Llegenda Event Storming"]
        direction TB

        Event["Event"]:::event
        Command["Command"]:::command
        Aggregate["Aggregate"]:::aggregate
        Policy["Policy"]:::policy
        Actor["Actor"]:::actor
        Note["Note"]:::note
    end

    classDef event fill:#fc5e03,stroke:#782c00,stroke-width:2px,corner-radius:5px;
    classDef command fill:#00b2e8,stroke:#005c78,stroke-width:2px,corner-radius:5px;
    classDef aggregate fill:#ffbf00,stroke:#7a5c00,stroke-width:2px,corner-radius:5px;
    classDef policy fill:#6f00ff,stroke:#240054,stroke-width:2px,corner-radius:5px;
    classDef actor fill:#ffdd00,stroke:#756600,stroke-width:2px,corner-radius:5px;
    classDef note fill:#fa0000,stroke:#660000,stroke-width:2px,corner-radius:5px;
Per maximitzar l’efectivitat de les sessions vam desenvolupar un procés estructurat en diverses fases:
- Exploració d’Events de Domini (Foto inicial)
- Identificar els esdeveniments clau del sistema
- Ordenar-los cronològicament
- Detectar gaps i dependències
- Validar la seqüència amb els experts
-
Refinament i Anàlisi
- Afegir notes explicatives
- Documentar dubtes i preguntes
- Entrar més en detall en cada esdeveniment
- Marcar punts de decisió crítics
-
Modelatge del Domini
- Identificar agregats (aggregates) i les seves fronteres
- Definir actors i els seus rols
- Establir comandes (commands) que inicien processos
- Documentar polítiques (policies) i regles de negoci
- Identificar triggers externs i interns de cada esdeveniment
-
Documentació i Validació
- Netejar i organitzar la informació recollida
- Establir relacions clares entre elements
- Validar el model amb tots els stakeholders
- Crear documentació de referència
L’EventStorming no només ens va servir per entendre el domini, sinó que també va ser el punt de partida per aplicar els principis de Domain-Driven Design (DDD) tant a nivell estratègic com tàctic.
Domain-Driven Design Estratègic
Un dels punts més importants en la fase inicial del projecte va ser decidir com estructurar el domini a nivell estratègic. La complexitat del sistema, combinada amb la necessitat d’alinear els objectius tècnics amb els del negoci, ens va portar a adoptar principis de Domain-Driven Design (DDD).
Durant aquest procés, una de les eines més útils va ser el Context Mapping. Tot i que treballàvem amb un monolit encara pendent de refactorització, vam invertir temps a identificar diversos Bounded Contexts dins del domini. A la pràctica, això volia dir que, tot i haver descrit i delimitat diversos contextos conceptuals, a nivell tècnic operàvem dins d’un únic Bounded Context amb un sol Shared Kernel. Aquesta realitat monolítica no ens va impedir aprofitar els beneficis d’aquesta anàlisi.
Encara que no aprofundíssim en el Context Mapping de manera exhaustiva, utilitzar aquestes tècniques en aquesta etapa va ser clau per assegurar que el projecte tingués un camí clar cap a una arquitectura orientada al domini. Aquest enfocament no només facilita el desenvolupament tècnic, sinó que també promou una millor col·laboració entre els equips tècnics i els de negoci.
Establint els Límits (Bounded Contexts)
Identificar els Bounded Contexts ens va permetre entendre millor com es relacionaven les diferents parts del sistema, tant entre si com amb els sistemes externs. Aquest exercici no només ens va ajudar a gestionar la complexitat de manera més eficient, sinó que també va establir una base clara per als passos evolutius posteriors del projecte. A mesura que el sistema evolucioni cap a una arquitectura més modular, aquestes decisions inicials serviran de guia per descompondre el monòlit en components més manejables i alineats amb els contextos definits
També ens va ajudar a entendre on havíem de dirigir els esforços de desenvolupament i quines parts del sistema podien ser simplificades, desacoblades o eliminades. Tècnicament, ens vam centrar especialment en la implementació de Anti-Corruption Layers (ACL), ja que ens permetien interactuar amb sistemes externs sense comprometre la integritat del nostre sistema.
En el nostre cas, inicialment vam identificar cinc grans contexts clarament diferenciats:
- Assignació de comandes
- Generació d’etiquetes
- Preparació de comandes
- Integració E-commerce
- Preparació de comandes massiu
Aquestes decisions no només han establert els fonaments per a una arquitectura sostenible, sinó que també han garantit que els processos de desenvolupament siguin més focalitzats i alineats amb les necessitats del negoci.
Llenguatge Ubic (Ubiquitous language)
Un altre aspecte fonamental va ser establir un llenguatge ubic (ubiquitous language) sòlid. Els avantatges d’establir aquest llenguatge són molt superiors a qualsevol sobresforç de traducció o al risc de malinterpretar conceptes. Els experts de domini (Domain Experts) i els programadors han de coŀlaborar activament per crear aquest llenguatge comú, que va més enllà d’un simple glossari de termes. Es tracta d’un recurs viu i dinàmic que connecta l’equip tècnic amb els experts del domini.
L’esforç en la seva implementació ha facilitat la comunicació, reduït malentesos i assegurat que el codi sigui una representació fidel del domini. Desenvolupar software no és només una qüestió tècnica; és una activitat basada en la comunicació i la coŀlaboració. Gràcies al llenguatge ubic, tots els membres de l’equip treballen alineats, cosa que resulta en solucions tècniques més eficients i que responen millor a les necessitats del negoci.
Domain-Driven Design Tàctic
Un cop definit el marc estratègic, vam passar a implementar principis de DDD tàctic en el sistema. Això ens va permetre estructurar el codi de manera que reflectís la realitat del domini i fos més sostenible a llarg termini.
Entitats (Entities) i Objectes de Valor (Value Objects)
Les entitats (Entities) i els objectes de valor (Value Objects) són dos conceptes fonamentals en el Domain-Driven Design (DDD). Per entendre com funcionen, és important destacar les seves diferències i el paper que juguen dins del domini.
Entitats (Entities)
Les entitats són elements del domini que tenen una identitat única que perdura al llarg del temps, fins i tot si els seus atributs canvien. Aquesta identitat única és el que les distingeix d’altres elements del mateix tipus. A més, les entitats solen tenir un cicle de vida definit dins del sistema. Exemples d’entitats que vam identificar en el projecte són:
- Order: Representa una ordre de compra amb una identitat única i un estat associat.
- Product: Element del catàleg amb atributs com el codi SKU, preu i descripció.
- Carrier: Empresa encarregada de lliurar les comandes amb opcions de servei específiques.
- Shop: Identifica de quin e-commerce o plataforma ens ha arribat la comanda.
- Customer: Persona o entitat que realitza la comanda i rep el producte.
Objectes de Valor (Value Objects)
Els objectes de valor, en canvi, són elements del domini que no tenen identitat pròpia. El seu valor és el que els defineix, i per això, dos objectes de valor amb els mateixos atributs són considerats equivalents. Això els fa immutables i ideals per encapsular conceptes clau que poden aparèixer en diverses parts del domini. Alguns exemples d’objectes de valor en el projecte inclouen:
- ProductReference: Codi únic per identificar un producte.
- ProductEan13: Codi de barres EAN-13 associat a un producte.
- OrderReference: Identificador únic d’una comanda.
- Price: Amb moneda i valor precís.
- Weight: Amb unitats de mesura estandarditzades.
- ShippingNumber: Número d’identificació per seguiment.
Aquest enfocament ens ajuda a crear codi més comprensible i modular, ja que cada element del sistema té una responsabilitat clara i ben definida.
Exemple d’un objecte de valor:
<?php
readonly class ProductEan13
{
    public string $value;

    public function __construct(
        string $value
    )
    {
        $pattern = '/^\d{13}$/';
        if (!preg_match($pattern, $value)) {
            throw new \Exception('Invalid product Ean13');
        }
        $this->value = $value;
    }
}
Serveis (Services)
En una aplicació complexa com la nostra, el concepte de Serveis juga un paper central en el manteniment d’un codi net i modular. Els serveis es classifiquen en diferents capes i tipus segons el seu propòsit i els patrons que implementen. Explorem l’estructura i els patrons que fem servir per organitzar i implementar serveis de manera efectiva.
Serveis de Domini
Els Serveis de Domini encapsulen lògica de negoci que no encaixa directament en cap entitat o valor específic. Són serveis que operen estrictament dins de les regles del domini i no tenen dependències amb components d’infraestructura.
<?php
class CheapestCarrierGetter
{
    public function get(
        DeliveryOptionCarrierCollection $deliveryOptionCarriers,
        Weight                          $orderWeight,
        Country                         $country,
        PostalCode                      $postalCode,
        bool                            $isCashOnDelivery = false,
    ): Carrier {
        // Lògica per obtenir el transportista més econòmic
    }
}
Serveis d’Aplicació
Els Serveis d’Aplicació encapsulen i coordinen lògica que combina operacions de domini amb interaccions externes per implementar escenaris específics de negoci o aplicació. Aquests serveis centralitzen i simplifiquen la implementació d’operacions complexes, assegurant una separació clara entre el domini i la infraestructura. Els més coneguts són els casos d’ús (use cases) però en el nostre cas també tindrem Command Handlers i Event Handlers.
graph TD
    ApplicationServices["Application Services"] --> UseCases["Use Cases"]
    ApplicationServices --> EventHandlers["Event Handlers"]
    ApplicationServices --> CommandHandlers["Command Handlers"]
Els Use Cases representen accions o processos específics que l’aplicació necessita realitzar per complir amb els requisits de negoci. Encapsulen la lògica necessària per executar operacions complexes, incloent-hi interaccions amb serveis de domini i infraestructura, mantenint el domini net i focalitzat. Podriem dir que la seva responsabilitat hauria de ser nomes la d’orquestrar entre aquestes dues capes, i deixant la responsabilitat cap al domini, com diu Vaughn Vernon “Keep Application Services thin, using them only to coordinate tasks on the model.”
Els Command Handlers són la porta d’entrada per a les modificacions en el domini. En rebre un Command, validen la petició, deleguen la lògica de negoci als agregats corresponents i, finalment, publiquen un esdeveniment que reflecteix el canvi produït en el sistema.
D’altra banda els Event Handlers actuen com a listeners a canvis en el sistema. Escolten esdeveniments i executen accions específiques en resposta, com ara enviar notificacions, actualitzar altres agregats o integrar-se amb sistemes externs. Aquesta reacció desacoblada permet construir sistemes més flexibles i escalables. Ampliaré els detalls i conceptes en pròximes entrades quan parlem sobre l’evolució de l’aplicatiu com a una arquitectura basada en events i sistemes de cues(Event-Driven Architecture, EDA).
<?php
readonly class NotifyShopOnOrderShipped implements EventHandlerInterface
{
    public function __construct(
        private OrderRepositoryInterface    $orderRepository,
        private ExternalOrderUpdaterFactory $externalOrderUpdaterFactory,
        private LoggerInterface             $logger
    ) {}

    public function __invoke(OrderShippedDomainEvent $event): void
    {
        // Lògica per notificar la botiga quan una comanda ha estat enviada
        $order = $this->orderRepository->findById($event->getOrderId());
        if (!$order) {
            $this->logger->error("Comanda no trobada", ['orderId' => $event->getOrderId()]);
            return;
        }

        $updater = $this->externalOrderUpdaterFactory->create($order);
        $updater->updateStatus('shipped');

        $this->logger->info("Notificació d'enviament completada", ['orderId' => $order->getId()]);
    }
}
Serveis d’Infraestructura
Els Serveis d’Infraestructura implementen operacions que depenen de components externs com bases de dades, sistemes de fitxers o serveis de tercers. Sovint actuen com adaptadors per garantir que el domini es mantingui agnòstic a la implementació concreta.
<?php
class MonologLogger implements LoggerInterface
{
    private $logger;

    public function __construct(Logger $logger)
    {
        $this->logger = $logger;
    }

    public function info(string $message, array $context = []): void
    {
        $this->logger->info($message, $context);
    }

    public function warning(string $message, array $context = []): void
    {
        $this->logger->warning($message, $context);
    }

    public function critical(string $message, array $context = []): void
    {
        $this->logger->critical($message, $context);
    }

    public function error(string $message, array $context = []): void
    {
        $this->logger->error($message, $context);
    }
}
Classificació dels serveis
Com hem vist, els serveis ens serveixen per desacoblar i descomposar lògica de la nostra aplicació d’una forma més granular i independent., aquí us deixo una classificació de serveis comuns que hem identificat en els nostre projecte, agrupant-los segons la seva funció principal i associant-los a patrons de disseny coneguts. Aquesta classificació ens permet tenir una visió més estructurada de la nostra arquitectura i facilita la presa de decisions a l’hora de dissenyar noves funcionalitats.
| Tipus de Servei |
Descripció |
Patró |
Exemple |
| Transformers |
Converteixen dades entre diferents formats o representacions. |
Adapter |
Convertir respostes d’API externes en models de domini. |
| Builders |
Construeixen objectes complexos pas a pas. |
Builder |
Crear un objecte Order. |
| Factories |
Creen objectes de domini assegurant que compleixen regles i restriccions. |
Factory |
Crear instàncies de Product. |
| Presenters |
Donen format a les dades per a la interfície d’usuari o respostes d’API. |
Decorator |
Enriquir dades per mostrar-les a l’usuari. |
| Notifiers |
Envien notificacions (correu, SMS, etc.). |
Observer |
Notificar l’usuari de canvis importants. |
| Validators |
Asseguren que objectes compleixin regles de negoci. |
Strategy |
Validar sol·licituds d’usuari o formularis. |
| Clients |
Interactuen amb aplicacions o serveis externs. |
Proxy |
Consumir APIs externes per obtenir informació. |
Tots aquests conceptes de domini són només una petita mostra de tot el que vam arribar a fer modelat. Evidentment, tampoc ho vam fer de cop ni vam encertar tot a la primera: hi ha moltes parts que encara van quedar pendents de reestructurar, conceptes que no vam acabar d’aclarir del tot i repositoris que sabíem que no tenien sentit, però que havíem de mantenir per funcionalitats, però que haviem d’acabar d’eliminar.
Però amb aquesta feina feta inicialment, es va permetre que tot l’equip participés en aquest procés i tingués un compromís (commitment) per tot el que estàvem construint.
Per aprofundir en aquests conceptes de DDD i com aplicar-los, recomano llegir els llibres següents:
- “Domain-Driven Design: Tackling Complexity in the Heart of Software” d’Eric Evans: L’obra fundacional sobre DDD que introdueix i explica en profunditat els conceptes d’entitats i objectes de valor.
- “Implementing Domain-Driven Design” de Vaughn Vernon: Un llibre pràctic que ofereix exemples concrets de com implementar DDD en projectes reals.
- “Domain-Driven Design in PHP” de Carlos Buenosvinos, Christian Soronellas & Keyvan Akbary
Construïnt equip
El procés d’adopció de DDD va anar paraŀlel a la formació i evolució de l’equip. Aquí és on vull parlar del model d’etapes de Tuckman (1965): Forming, Storming, Norming, Performing, ja que considero que l’evolució de l’equip va seguir aquesta seqüència i això ens va ajudar d’una banda a alinear les nostres pràctiques tècniques i d’altra a desenvolupar una cultura de col·laboració i confiança en l’equip. Tal com descriu Tuckman (1965), comprendre i abraçar aquestes etapes és clau per construir equips d’alt rendiment. La referència original pot trobar-se al seu treball: Tuckman, B. W. (1965). Developmental sequence in small groups. Psychological Bulletin, 63(6), 384–399.
Segons aquest model, els equips passen per quatre fases distintives per arribar al màxim rendiment. Durant la fase inicial (Forming), els membres de l’equip s’introdueixen i defineixen objectius generals. A la fase de Storming, emergeixen conflictes mentre es comencen a establir els rols. Amb el temps, en la fase de Norming, els equips aconsegueixen una dinàmica de treball cohesionada, que culmina en Performing, on es treballa de manera eficient cap als objectius comuns.
L’equip es va formar inicialment amb dos desenvolupadors, que van començar revisant el projecte i documentant el seu funcionament, mentre altres membres tancaven els seus respectius projectes per incorporar-se en aquest. Per la meva banda em vaig incorporar com a tech lead i vaig començar a repasar la nova documentació que s’havia generat i establir establir les bases tècniques i organitzatives del projecte i l’equip en quant a processos, estàndards i eines.
Tempesta (Storming)
No podríem dir que hi va haver grans desavinences dins l’equip, però sí que vam veure la necessitat de “regular” certs aspectes per tal d’anar tots més alineats. Es va fer més palesa aquesta necessitat quan vam incorporar dues persones més a l’equip i el roadmap començava a prendre forma. Això va fer que ens plantegéssim com volíem treballar, comunicar-nos i sobretot com fer visibles totes aquestes decisions i coneixements en un projecte que estava en constant evolució.
Així que rapidament vam passar a la fase de Norming per establir les bases de com volíem treballar i com volíem organitzar-nos.
Estandarització (Norming)
Durant aquest període vam acordar diversos aspectes per facilitar el treball en equip:
- Team Agreements: Normes per al treball en equip i la comunicació com la definició de cerimonies, horaris de reunions, canals de comunicació, etc.
- Coding Standards: Guies per escriure codi net i mantenible seguint les bases de DDD, Arquitectura Hexagonal i principis SOLID.
- Procés de Desenvolupament: Definició de les eines, processos i pràctiques a seguir per a mantenir un flux de treball eficient, amb l’objectiu de millorar la qualitat del codi i la productivitat de l’equip fomentant una cultura de col·laboració i aprenentatge.
- Límits de WIP (Work In Progress): Per garantir un flux sostenible de treball. Té un capitol a part per reforçar la seva importància, com a part de la metodologia Lean a la que ens vam acostar.
- Deployments: Regles per a desplegaments controlats i fiables, incloent les limitacions horàries i els procediments de rollback.
- Deute Tècnic: Definició i gestió del deute tècnic acumulat així com facilitar un marc per identifcar-lo i prioritzar-lo si s’escau
- ADR: Registre i justificació de decisions arquitectòniques per garantir la coherència i la traçabilitat de les decisions preses.
Amb tota la feina feta en les etapes anteriors, havíem creat un marc de treball que ens permetia centrar-nos en el desenvolupament del producte de manera eficient i sense preocupacions, més enllà de les de prioritzar aquelles iniciatives que aportessin més valor en el context de cada moment. Això va permetre que l’equip es centressi en la implementació de funcionalitats de negoci a la vegada que es millorava la qualitat del codi, ens formavem i manteniem la documentació viva.
Documentació
Tot aquest esforç no tenia sentit si no es feia d’alguna manera visible. Ho vam documentar perquè estigués accessible en qualsevol moment i fàcil d’actualitzar. Utilitzàvem GitLab per gestionar el codi del projecte, així que vam activar la funcionalitat de GitLab Pages i després d’una mica d’investigació vam utilitzar Jekyll amb el tema Just the Docs.
Per organitzar la informació, vam basar-nos en el model Diátaxis:
- Tutorials: Guies per a funcionalitats del aplicatiu, destinades principalment a l’usuari final (exemple: Configuració de Transportistes).
- Guies: Instruccions pràctiques i solucions de problemes específics, tant per a usuaris finals com desenvolupadors (exemple: Com instal·lar l’aplicació).
- Explicacions: Coneixements en profunditat dels processos d’equip i estàndards (exemple: Team agreements i estàndards de codi).
- Referències: Informació detallada per a desenvolupadors (exemple: ADRs, arquitectura del aplicatiu).
Un següent pas que no vam arribar a implementar del tot va ser automatitzar la documentació tècnica mitjançant Event Catalog i AsyncAPI.
13 Jan 2025
Quan parlem de software legacy, sovint pensem en aplicacions antiquades o mal dissenyades. Però la realitat és que el “legacy” pot ser qualsevol aplicació que, tot i funcionar correctament, presenta reptes significatius per a la seva evolució i manteniment. Aquesta és la història de com vam abordar la internalització d’una aplicació de gestió logística (Order Management System, OMS), amb el repte afegit d’una integració amb una nova plataforma de comerç electrònic.
El context inicial
L’any 2018 es va desenvolupar l’aplicació amb l’objectiu d’optimitzar el procés de preparació de comandes d’un ecommerce en alça i garantir així una integració eficient amb diferents operadors logístics. Desenvolupada en PHP (Symfony), MySQL, Socket.io i jQuery, l’aplicació gestionava des de l’empaquetat fins a l’enviament, amb funcionalitats com el seguiment d’enviaments, connexió amb transportistes, generació d’etiquetes i mètriques de rendiment de la preparació de les comandes.
Durant anys, aquesta eina va complir el seu propòsit, però amb el temps i l’evolució del negoci, van començar a evidenciar-se limitacions importants.
Deute tècnic acumulat
La situació del deute tècnic era especialment preocupant, ja que afectava múltiples capes del projecte. A nivell d’infraestructura tecnològica, l’aplicació s’executava sobre versions obsoletes tant del framework com del llenguatge base:
- La versió de Symfony (4.0) no era LTS (Long Term Support) i havia deixat de rebre actualitzacions de seguretat des de gener de 2019
- PHP 7.1, també havia arribat al final del seu cicle de suport, deixant el sistema sense actualitzacions crítiques de seguretat
Però més enllà de les versions obsoletes, el projecte presentava mancances significatives en aspectes fonamentals del desenvolupament de software:
-
Testing inexistent o inadequat: La falta de tests automatitzats (unitaris, d’integració i end-to-end) no només dificultava la detecció primerenca d’errors, sinó que també feia que qualsevol modificació fos un risc potencial per a l’estabilitat del sistema.
-
Absència d’estàndards de codi: El codebase no seguia patrons ni estàndards documentats, i els que s’aplicaven no estaven alineats amb les millors pràctiques de la indústria. Això dificultava tant el manteniment com la incorporació de nous desenvolupadors al projecte.
-
Documentació insuficient: La documentació existent era escassa i sovint incompleta. Això no només afectava el desenvolupament tècnic, sinó també la comprensió dels processos de negoci implementats en el codi.
-
Control de versions deficient: L’històric de Git era poc explicatiu, amb commits poc granulars i missatges que no seguien cap convenció ni aportaven context sobre els canvis realitzats. Això dificultava entendre l’evolució del codi i les decisions preses al llarg del temps.
Aquesta acumulació de deute tècnic no només representava un risc per a l’estabilitat i seguretat del sistema, sinó que també:
- Alentia el ritme de desenvolupament de noves funcionalitats
- Augmentava el risc d’introducció d’errors
- Dificultava l’onboarding de nous membres a l’equip
- Incrementava els costos de manteniment
- Complicava la diagnosi i resolució de problemes
Limitacions estructurals
L’arquitectura inicial presentava problemes d’acoblament que afectaven greument la seva flexibilitat i escalabilitat:
- Dependència total amb l’e-commerce principal: L’aplicació no podia operar de manera autònoma, ja que totes les operacions logístiques depenien directament de les dades i processos de l’e-commerce. Això feia que qualsevol canvi en la plataforma principal pogués trencar la funcionalitat del sistema.
- Base de dades compartida que generava problemes de rendiment: Tant l’aplicació logística com l’e-commerce utilitzaven la mateixa base de dades, fet que ocasionava problemes de rendiment, especialment durant pics de càrrega en qualsevol de les dues aplicacions. A més, aquesta configuració complicava la gestió de permisos, ja que qualsevol accés a la base de dades podia comprometre dades crítiques d’altres sistemes.
- Impossibilitat de funcionar de manera independent: L’aplicació estava dissenyada per operar exclusivament en conjunt amb l’e-commerce. Això no només limitava la seva portabilitat, sinó que també dificultava proves en entorns aïllats o la migració cap a altres plataformes. Les seves dependències no estaven adequadament encapsulades, fent que qualsevol intent d’aïllar-la requerís canvis massius i costosos en tot el sistema, en les principals classes no es respectava el principi de separació de responsabilitats (Single Responsibility Principle).
- Dificultat per implementar noves funcionalitats:La falta d’adhesió a principis com l’Obert/Tancat (OCP) i la Substitució de Liskov (LSP) dificultava enormement l’evolució del sistema. Les noves funcionalitats requerien modificar codi existent, augmentant el risc d’introduir regressions. A més, la dependència directa entre mòduls feia gairebé impossible seguir el principi d’Inversió de Dependències (DIP).
Aquest conjunt de limitacions estructurals no només reduïa la mantenibilitat i escalabilitat del sistema, sinó que també incrementava els riscos associats a qualsevol modificació o evolució, situant l’aplicació en un estat tècnicament fràgil i estratègicament vulnerable.
Gestió del desenvolupament i alineació estratègica
Un dels reptes més significatius no era només tècnic, sinó estratègic. El desenvolupament extern, tot i ser funcionalment correcte, presentava limitacions importants en l’àmbit organitzatiu:
- Desconnexió amb l’estratègia global: El desenvolupament es realitzava de manera aïllada, sense una visió completa dels objectius i processos interns de l’empresa. Això resultava en funcionalitats que, tot i podien ser tècnicament correctes, no sempre s’alineaven amb les necessitats reals del negoci.
- Manca de priorització estratègica: Les noves funcionalitats s’implementaven sense un procés clar de valoració i priorització. No es qüestionava si una funcionalitat era realment necessària, si era la millor manera d’implementar-la, o si existien alternatives més eficients.
- Desenvolupament reactiu vs. proactiu: El desenvolupament seguia un patró majoritàriament reactiu, resolent necessitats immediates sense considerar l’impacte a llarg termini o les possibles sinergies amb altres processos de l’empresa.
- Absència de processos de validació: La manca d’un procés estructurat de revisió i validació resultava en funcionalitats que, tot i ser operatives, no sempre representaven la millor solució per als usuaris finals o per als objectius globals de l’empresa.
Aquesta situació no era sostenible a llarg termini, ja que:
- Generava un producte cada cop més desalineat amb les necessitats reals
- Dificultava la integració amb altres sistemes i processos de l’empresa
- Complicava la presa de decisions estratègiques sobre el producte
- Limitava la capacitat d’innovació i millora continua de l’equip
Impacte del cost basal
Un aspecte sovint oblidat però especialment rellevant en aquest projecte va ser el cost basal, un concepte que considero clau en el desenvolupament de software que es refereix al cost mínim necessari per mantenir operatiu un sistema, fins i tot sense afegir-hi noves funcionalitats o fer-li millores.
En el nostre cas, el cost basal incloïa totes aquelles despeses derivades de la necessitat de mantenir versions obsoletes del framework i del llenguatge, solucionar incidències urgents derivades del deute tècnic acumulat, gestionar la dependència amb altres sistemes, adaptar-se a una arquitectura acoplada i poc coneixement del domini. Tot això consumia una part significativa dels recursos disponibles, afectant directament la capacitat d’invertir en innovació i millora contínua.
Si bé aquest factor no va ser determinant per prendre la decisió d’internalitzar el desenvolupament, va tenir un pes rellevant en la diagnosi inicial del projecte. Sovint, el cost basal es passa per alt en l’avaluació de la sostenibilitat d’un sistema, però en aquest cas, era una evidència clara que l’estratègia actual no era sostenible a llarg termini. A més, va quedar palès, com veurem en posteriors articles, que qualsevol intent de mantenir l’estructura existent augmentaria el cost basal de manera exponencial amb el pas del temps.
Per a una explicació més detallada sobre el concepte de cost basal i la seva importància, recomano consultar l’article original d’Eduardo Ferro
El punt d’inflexió: Un nou repte i una decisió estratègica
En qualsevol projecte de refactorització, es poden adoptar varies estratègies i es habitual trobar-se amb la dicotomia de: l’estratègia (strangler fig) o començar de zero amb un “big bang rewrite”.
Inicialment, la decisió tècnica va ser treballar dins del mateix projecte legacy, aplicant l’estratègia Strangler Fig, un enfocament que consisteix a desenvolupar un nou mòdul o sistema que, progressivament, substitueixi les parts del sistema antic. Aquesta estratègia ens permetia fer canvis paral·lels (parallel changes), reduint riscos i mantenint la funcionalitat actual mentre construíem una base més sòlida per a les funcionalitats futures.
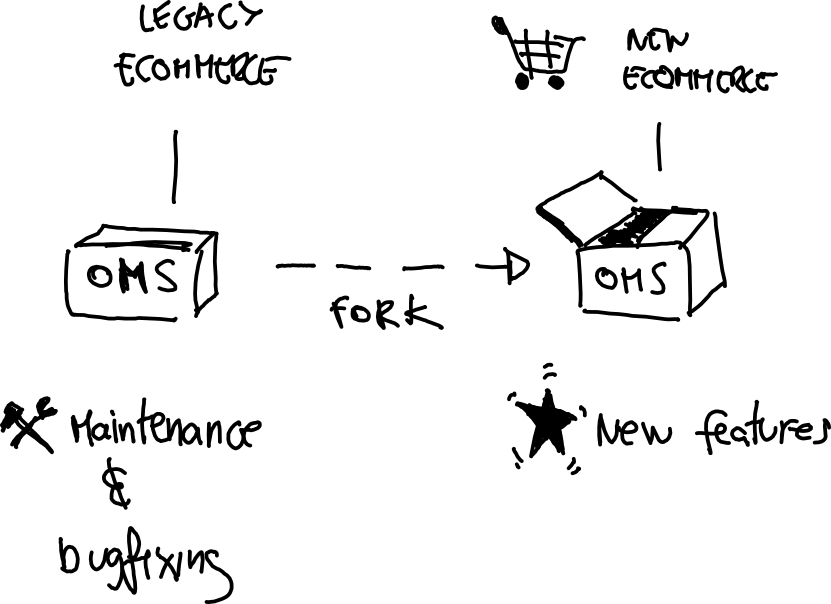
Tanmateix, des del punt de vista de negoci, es va considerar que aquesta opció suposava un risc massa elevat per al sistema actual, que ja estava operatiu i complint les seves funcions. Es va prendre la decisió d’evitar tocar el projecte existent i apostar per desenvolupar una aplicació independent que complís amb els nous requeriments.
Aquest canvi de rumb ens va portar a fer un fork de la codebase existent, una decisió que, tot i ser tècnicament viable, comportava certs hàndicaps:
- Duplicació del codebase: Ara caldria mantenir dues bases de codi separades.
- Bases de dades separades: Es va haver de duplicar i adaptar l’estructura de dades per a cadascun dels sistemes.
- Infraestructura replicada: Era necessari desplegar un servidor independent i garantir una observabilitat adequada per a cada sistema.
- Major carrega cognitiva per a l’equip: Totes aquestes duplicitats requerien un esforç addicional per mantenir consistència entre els dos sistemes, augmentant la complexitat i el risc d’errors de l’equip.
Aquest enfocament ens va permetre avançar cap a una solució independent, assegurant l’estabilitat del sistema existent mentre desenvolupàvem un projecte alineat amb els nous objectius estratègics. Tanmateix, era imprescindible analitzar en detall els pros i contres per abordar aquest repte amb confiança i planificació. A més, es va establir un compromís nivell de negoci per no ampliar funcionalitats i mantenir un control estricte del backlog del projecte fins a completar la migració al nou e-commerce.
| Pros |
Contres |
| Treballar en un entorn no productiu, reduint riscos en producció |
Necessitat de mantenir temporalment múltiples projectes |
| Llibertat per implementar noves tecnologies i patrons des de zero |
Duplicació temporal d’esforços en manteniment |
| Dpreocupar-se per les limitacions tècniques o dependències del sistema antic |
La duplicació de funcionalitats pot alentir el desenvolupament a llarg termini per la necessitat de sincronitzar canvis entre sistemes |
| Capacitat de centrar-se exclusivament en les funcionalitats necessàries |
Risc per als deadline per tenir dues bases de codi |
| Oportunitat d’implementar bones pràctiques des del principi |
Complexitat en la gestió dels projectes |
| Major facilitat per incorporar testing des de l’inici |
Necessitat de mantenir compatibilitat amb dades històriques |
| Flexibilitat per adaptar-se a nous requeriments de negoci |
Cost inicial més alt en temps i recursos |
| Millor alineació amb l’estratègia global de l’empresa |
Possible pèrdua temporal de funcionalitats no essencials |
Conclusions i següents passos
La decisió d’internalitzar i reescriure un software legacy mai és fàcil, especialment quan aquest software compleix la seva funció. La dita de si funciona no ho toquis hi serà sempre present. No obstant això, de vegades és necessari fer un pas enrere per poder fer-ne dos endavant.
En els propers articles d’aquesta sèrie, explorarem com vam abordar aquests reptes, les decisions tècniques i estratègiques que vam prendre, i com vam transformar aquests desafiaments en oportunitats de millora i creixement de tot l’equip.

